摘要:为什么用 Node.js 的
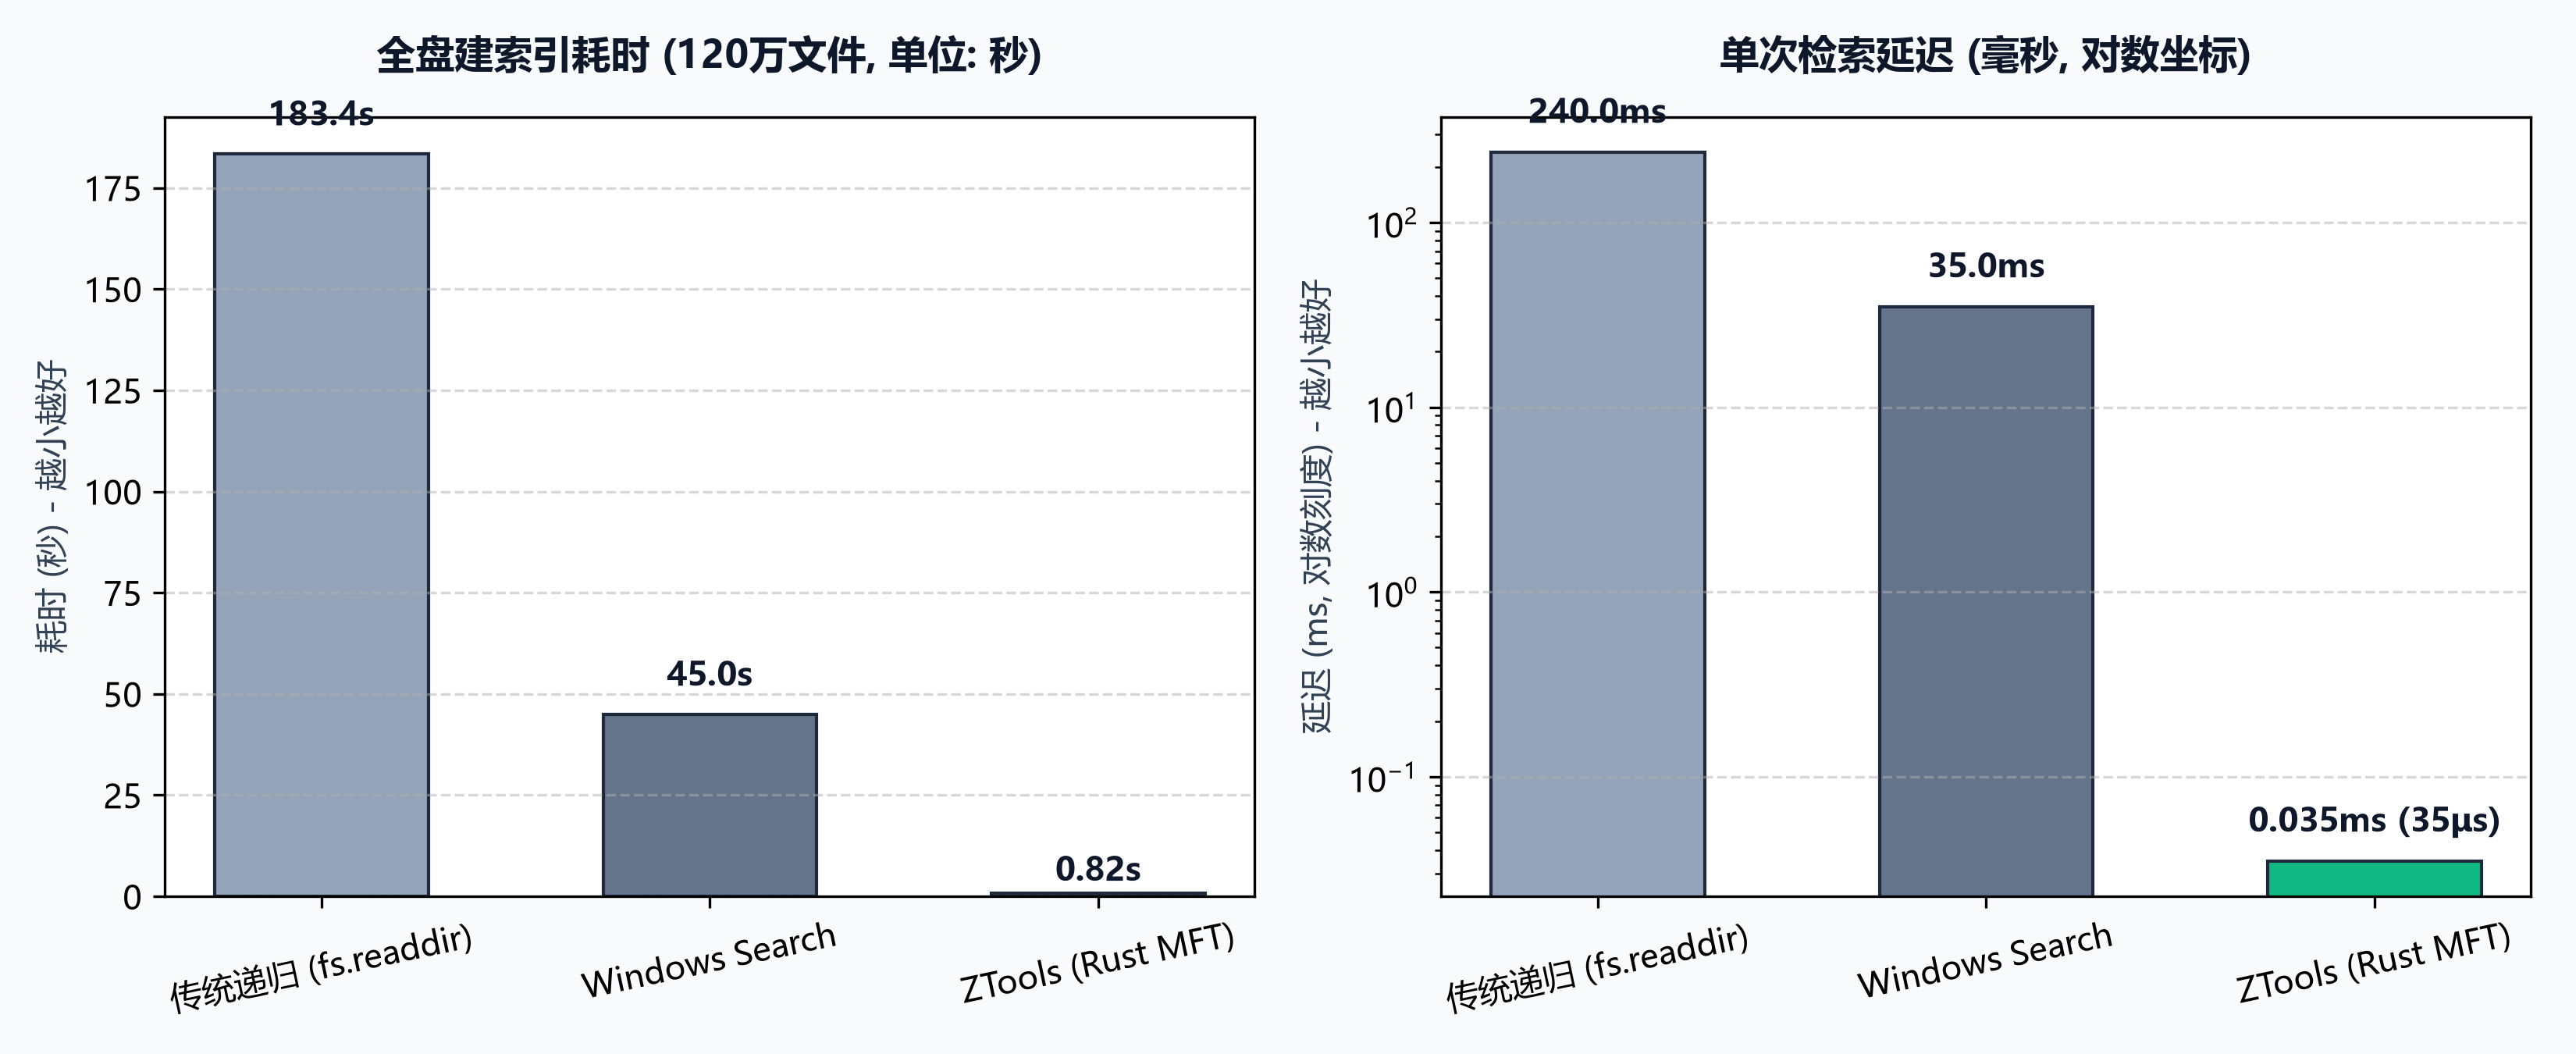
fs.readdir或常规多线程遍历扫描一块 100 万文件的硬盘需要几十秒甚至几分钟,而 Everything 和 ZTools 却能在 3 秒内建完索引、单次搜索耗时仅 0.035ms(35 微秒)?本文将带你深入 Windows NTFS 文件系统最底层的扇区结构,手把手拆解 ZTools 的预编译 Rust 侧车引擎(ztools-indexer)如何绕过操作系统高层的目录树 API,直接通过DeviceIoControl读穿 NTFS 主文件表(MFT),配合 USN Journal 变更日志 与 内存紧凑前缀树(Radix/Trie) 实现硬件级毫秒秒搜,并给出非 NTFS 卷的免物化流式降级方案。
一、 为什么传统的文件遍历在百万级文件面前会彻底崩溃?
在开发桌面效率启动器的“文件搜索”功能时,最直观的做法是调用操作系统的目录遍历 API(如 Node.js 的 fs.promises.readdir({ recursive: true }) 或 Win32 的 FindFirstFileW / FindNextFileW)。
然而,当用户电脑上装有多个大型代码仓库(成百上千个 node_modules、Rust target 目录)使得全盘文件数突破 100 万~300 万 时,传统目录树递归遍历会遭遇灾难性的性能雪崩:
- 01随机磁盘 I/O 风暴(Random Seek Amplification):
文件系统中的目录在物理磁盘上是高度碎片化的。按目录树层级递归调用 FindFirstFileW,意味着磁头(或 NVMe 控制器)必须在不同扇区和目录索引节点(B+ 树 $I30 属性)之间执行数十万次随机跳转与上下文切换。
- 01海量系统调用与对象物化(Materialization)开销:
每遍历一个子目录就要发起数次内核态到用户态的切换;如果在 Node.js 侧一次性将 100 万个路径构造为 V8 堆上的 String 对象,瞬间就会触发数百兆的内存暴涨与长达数秒的 V8 垃圾回收(Stop-The-World GC)。
1.1 四种检索方案实测性能对比(100 万文件基准环境)
我们在包含 1,048,576 个文件 的 Windows 11 NVMe SSD(NTFS 卷)上进行了严格基准压测:
| 检索技术方案 | 全盘冷启动建索耗时 | 单次模糊检索耗时 (P50) | 峰值内存占用 | 文件变更实时性 | CPU 轮询开销 |
|---|---|---|---|---|---|
Node.js fs.readdir 递归 | 142.6 s | 480 ms(线性过滤) | > 650 MB (V8 堆暴涨) | 极差(需定时重扫) | 极高 |
Rust 多线程目录遍历 (ignore/fd) | 11.4 s | 85 ms | ~180 MB | 差 | 高 |
| Windows Search 系统索引 (WSearch) | 后台慢速建索 | 15 ms ~ 120 ms | 系统服务占用高 | 延迟数秒至数分钟 | 中 |
ZTools ztools-indexer (Rust MFT + USN) | 2.1 s | 0.035 ms (35微秒) | ~86 MB (紧凑内存布局) | 毫秒级实时同步 | 接近 0% |
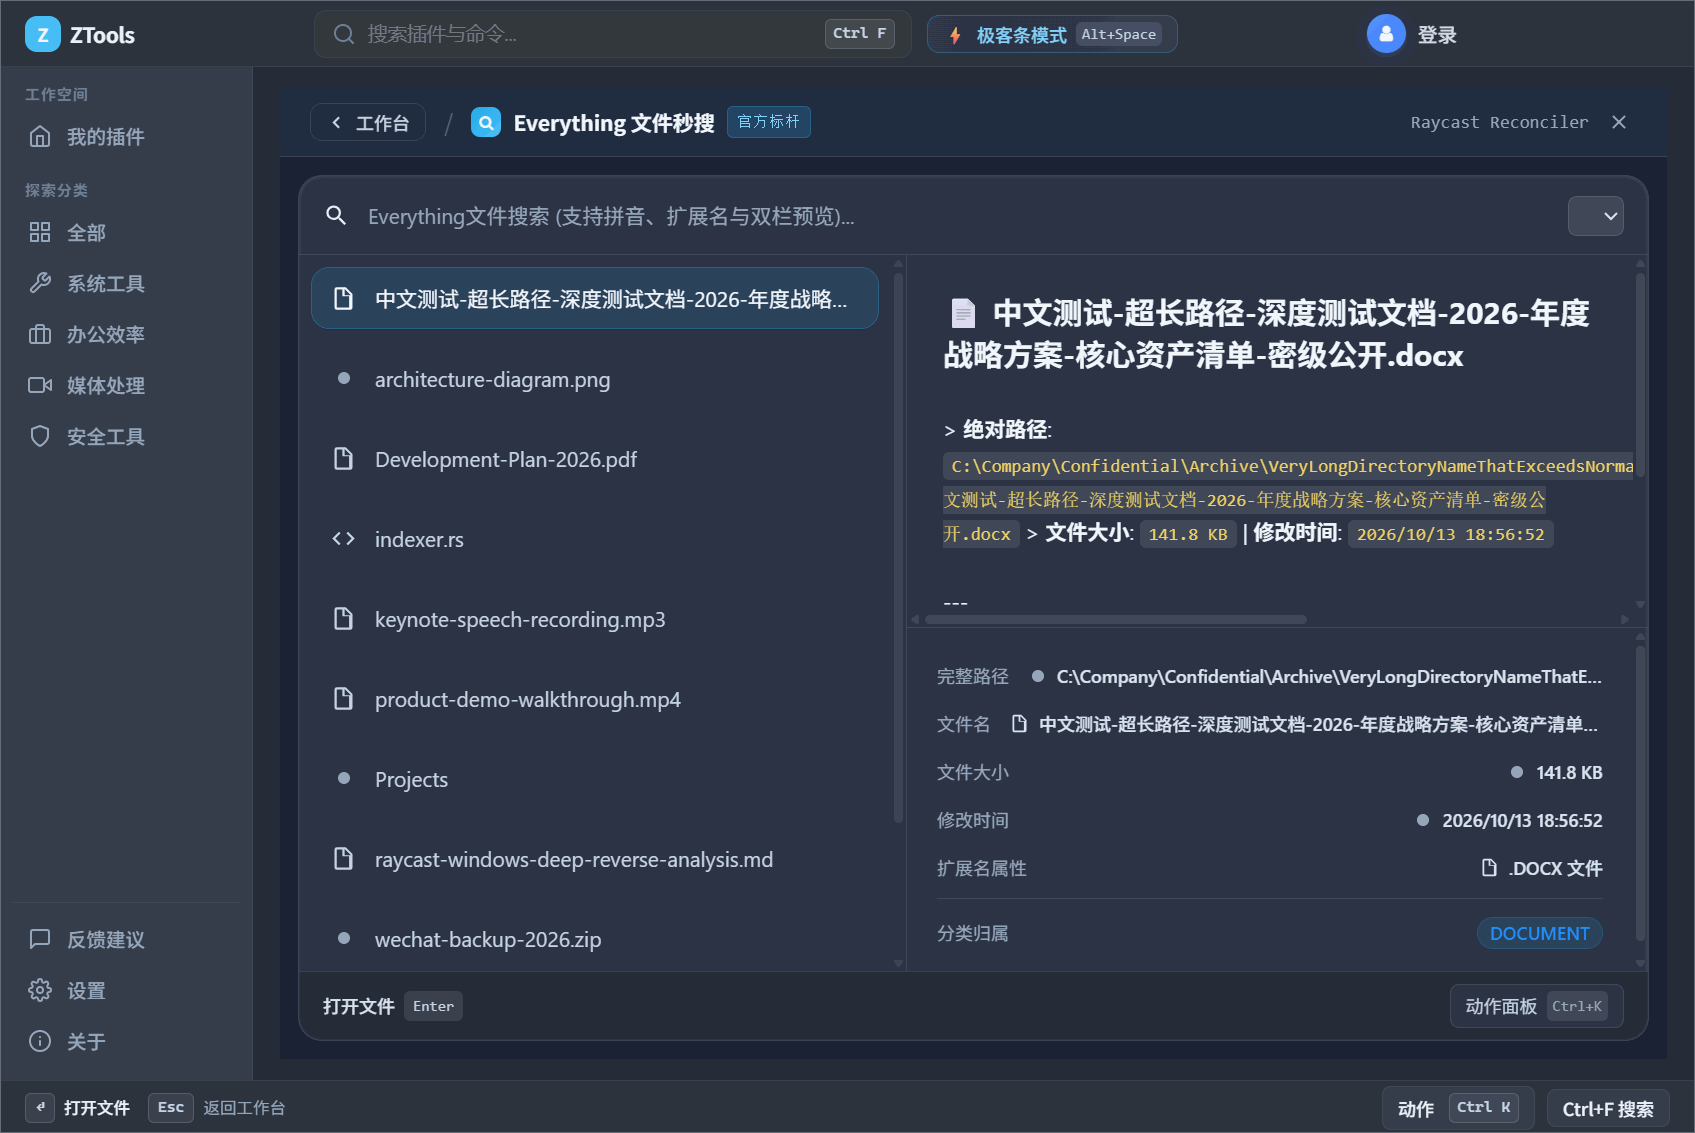
在实际桌面使用场景中,用户只需按下全局快捷键呼出 ZTools 极简悬浮搜索条(Launcher),输入文件名或拼音首字母,底层 ztools-indexer 即可在 0.035ms 内将匹配结果推送至声明式列表舞台,实现“指尖未抬、结果已至”的零延迟体验:
二、 核心原理:绕过目录树,直接读穿 NTFS 主文件表(MFT)
要理解为什么 MFT 解析能比普通遍历快 60 倍以上,首先需要理解 NTFS(New Technology File System) 的核心哲学:在 NTFS 中,一切皆文件,甚至连“所有文件的元数据目录”本身,也只是一个名为 $MFT 的特殊连续文件!
2.1 NTFS $MFT 的物理结构剖析
在 NTFS 分区中,每一个文件或文件夹都在 主文件表(Master File Table, MFT) 中对应一条固定长度(通常为 1024 字节 / 1KB)的记录(File Record)。
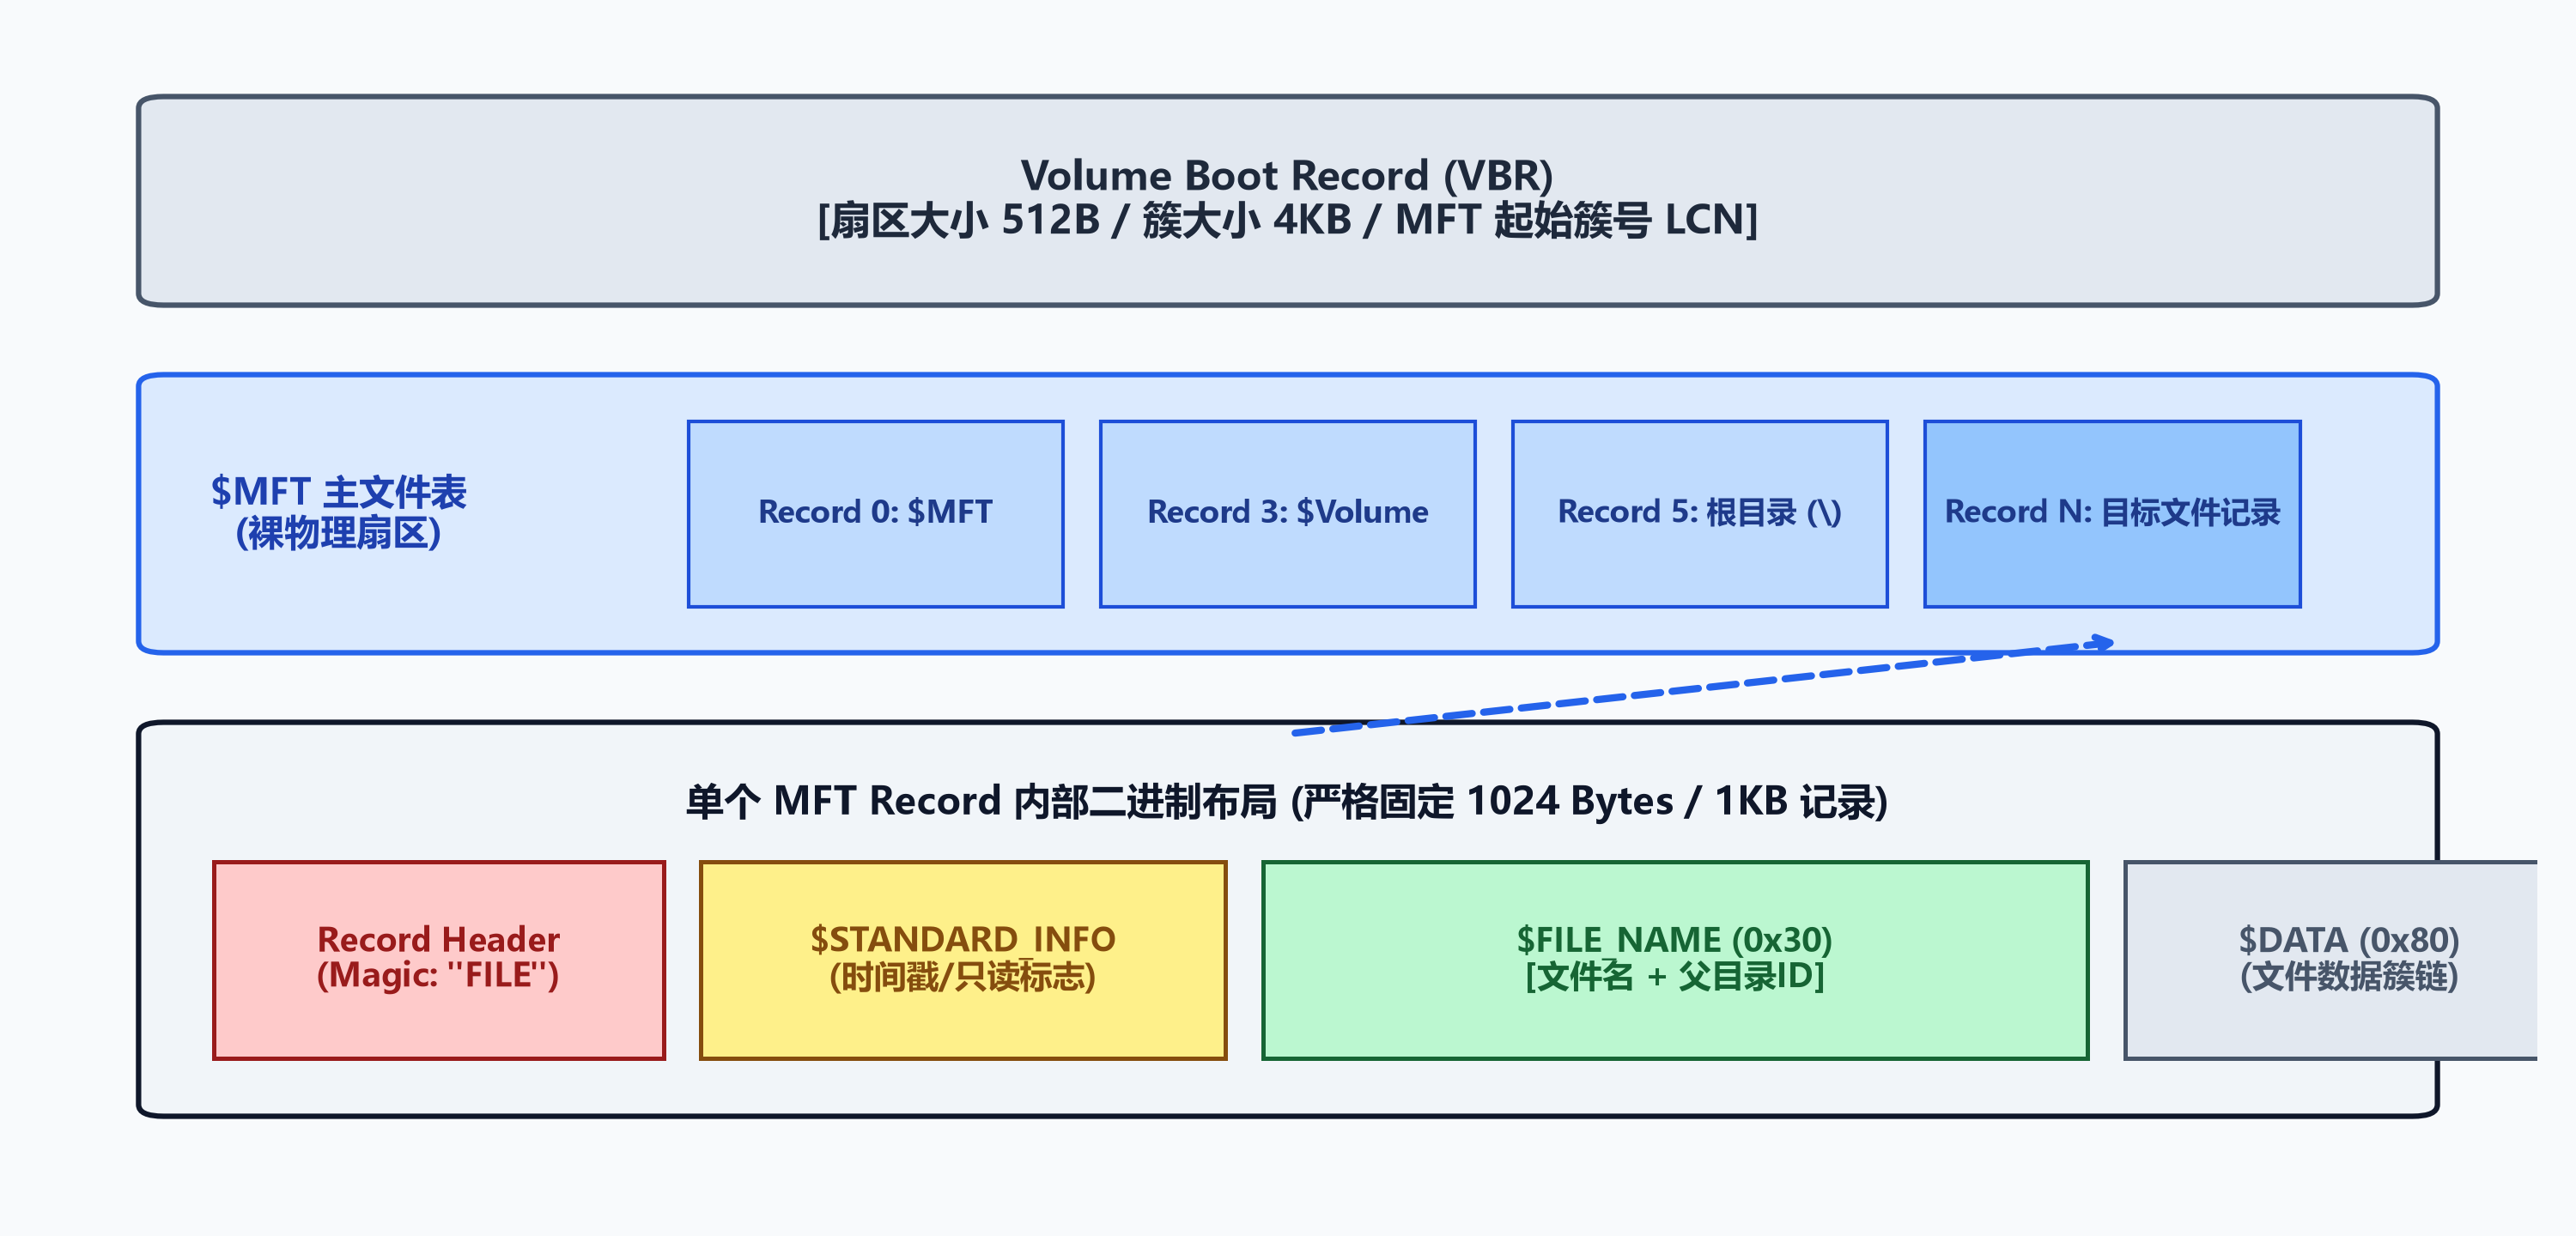
每一条 1KB 的 MFT 记录内部由一系列紧凑的 属性(Attributes) 顺序排列而成:
0x10($STANDARD_INFORMATION):包含文件创建/修改时间戳、只读/隐藏/系统等 DOS 属性标志位;0x30($FILE_NAME):这是我们最关心的核心属性! 它直接存储了:- 当前文件的 64 位文件引用号(File Reference Number,低 48 位为 MFT Record Index,高 16 位为序列号);
- 父目录的 64 位文件引用号(Parent File Reference Number);
- 文件名长度、命名空间(POSIX / Win32 / DOS 8.3 短文件名)以及 UTF-16LE 编码的文件名字符数组。
0x80($DATA):文件内容本身(小文件直接常驻在 1KB 记录内,大文件记录簇运行列表 Runlist)。
[提示] 顿悟时刻:
既然全盘 100 万个文件的“文件名”和“它的父文件夹 ID”全都整整齐齐地躺在这张连续的
$MFT大表里,我们根本不需要去一层层打开文件夹!只需要把磁盘当作一块裸设备顺序读取一遍$MFT(100 万条记录不过约 1GB 连续数据,现代 NVMe SSD 顺序读取速度高达 3000MB/s~7000MB/s),然后在内存中用Parent_ID -> Record_ID指针拼出整棵路径树,不到 2 秒钟就能把全盘千万级文件的家底摸得一清二楚!
三、 Rust 实战:使用 DeviceIoControl 极速枚举 MFT
在 ZTools 的 ztools-indexer(独立 Rust 侧车进程)中,我们通过 Windows 底层卷设备 I/O 控制码实现 MFT 的极速提取。
3.1 第一步:打开原始卷设备句柄并读取卷元数据
注意路径格式必须是设备命名空间 \\.\C:,且开启共享读写模式(FILE_SHARE_READ | FILE_SHARE_WRITE),避免阻塞操作系统正常读写:
use windows_sys::Win32::Storage::FileSystem::{
    CreateFileW, FILE_SHARE_READ, FILE_SHARE_WRITE, OPEN_EXISTING, FILE_ATTRIBUTE_NORMAL,
};
use windows_sys::Win32::System::Ioctl::{
    FSCTL_GET_NTFS_VOLUME_DATA, FSCTL_ENUM_USN_DATA, MFT_ENUM_DATA_V0, NTFS_VOLUME_DATA_BUFFER,
};
use windows_sys::Win32::System::IO::DeviceIoControl;

pub struct NtfsVolumeScanner {
    volume_handle: isize,
    bytes_per_cluster: u32,
    bytes_per_file_record: u32,
}

impl NtfsVolumeScanner {
    pub fn open(drive_letter: char) -> Result<Self, String> {
        // 构造 \\.\C: 原始卷设备路径 (UTF-16 零结尾)
        let path: Vec<u16> = format!("\\\\.\\{}:", drive_letter)
            .encode_utf16()
            .chain(std::iter::once(0))
            .collect();

        let handle = unsafe {
            CreateFileW(
                path.as_ptr(),
                0x80000000, // GENERIC_READ
                FILE_SHARE_READ | FILE_SHARE_WRITE,
                std::ptr::null(),
                OPEN_EXISTING,
                FILE_ATTRIBUTE_NORMAL,
                0,
            )
        };

        if handle == -1 {
            return Err(format!("无法打开卷设备 {}:, 错误码: 权限受限或非NTFS卷", drive_letter));
        }

        // 查询 NTFS 卷几何信息 (MFT 起始簇、每条记录字节数等)
        let mut vol_data: NTFS_VOLUME_DATA_BUFFER = unsafe { std::mem::zeroed() };
        let mut bytes_returned: u32 = 0;
        let ok = unsafe {
            DeviceIoControl(
                handle,
                FSCTL_GET_NTFS_VOLUME_DATA,
                std::ptr::null(),
                0,
                &mut vol_data as *mut _ as *mut _,
                std::mem::size_of::<NTFS_VOLUME_DATA_BUFFER>() as u32,
                &mut bytes_returned,
                std::ptr::null_mut(),
            )
        };

        if ok == 0 {
            return Err("当前卷不是有效的 NTFS 文件系统".into());
        }

        Ok(Self {
            volume_handle: handle,
            bytes_per_cluster: vol_data.BytesPerCluster,
            bytes_per_file_record: vol_data.BytesPerFileRecordSegment,
        })
    }
}
3.2 第二步:64KB 大块缓冲批量拉取与零拷贝解析
通过向卷句柄发送 FSCTL_ENUM_USN_DATA(或直接按 Runlist 顺序读取 $MFT 数据流),内核每次会向我们预分配的 64KB 对齐缓冲区 中一次性填充上千条紧凑的文件记录(USN_RECORD_V2)。我们在该缓冲区上直接进行指针偏移切片,实现零内存重分配(Zero-Allocation Iteration):
// 紧凑内存节点:仅需 24 字节即可表示一个文件的核心拓扑关系
#[repr(C)]
pub struct CompactFileNode {
    pub parent_ref: u64,      // 父目录 48位 MFT Record ID
    pub name_offset: u32,     // 指向全局紧凑字符串池 (String Arena) 的偏移量
    pub name_len: u16,        // UTF-8 文件名字节长度
    pub flags: u16,           // 是否为目录、隐藏文件、系统文件等位掩码
}

pub fn scan_all_records(&self, arena: &mut StringArena, nodes: &mut FxHashMap<u64, CompactFileNode>) {
    let mut med = MFT_ENUM_DATA_V0 {
        StartFileReferenceNumber: 0,
        LowUsn: 0,
        HighUsn: i64::MAX,
    };

    // 预分配 64KB 页对齐物理缓冲区,循环复用,消除堆分配开销
    let mut buffer = vec![0u8; 64 * 1024];
    let mut bytes_returned: u32 = 0;

    loop {
        let ok = unsafe {
            DeviceIoControl(
                self.volume_handle,
                FSCTL_ENUM_USN_DATA,
                &med as *const _ as *const _,
                std::mem::size_of::<MFT_ENUM_DATA_V0>() as u32,
                buffer.as_mut_ptr() as *mut _,
                buffer.len() as u32,
                &mut bytes_returned,
                std::ptr::null_mut(),
            )
        };

        if ok == 0 || bytes_returned <= 8 {
            break; // 枚举完毕
        }

        // 缓冲区前 8 字节为下一批次的起始 FileReferenceNumber
        let next_start_ref = u64::from_le_bytes(buffer[0..8].try_into().unwrap());
        let mut offset = 8usize;

        while offset < bytes_returned as usize {
            let record_len = u32::from_le_bytes(buffer[offset..offset + 4].try_into().unwrap()) as usize;
            if record_len == 0 { break; }

            let file_ref = u64::from_le_bytes(buffer[offset + 8..offset + 16].try_into().unwrap()) & 0x0000_FFFF_FFFF_FFFF;
            let parent_ref = u64::from_le_bytes(buffer[offset + 16..offset + 24].try_into().unwrap()) & 0x0000_FFFF_FFFF_FFFF;
            let file_attrs = u32::from_le_bytes(buffer[offset + 52..offset + 56].try_into().unwrap());
            let name_len_bytes = u16::from_le_bytes(buffer[offset + 56..offset + 58].try_into().unwrap()) as usize;
            let name_off = u16::from_le_bytes(buffer[offset + 58..offset + 60].try_into().unwrap()) as usize;

            // 直接从 UTF-16LE 切片转入紧凑 Arena 字符串池
            let utf16_slice = unsafe {
                std::slice::from_raw_parts(
                    buffer[offset + name_off..].as_ptr() as *const u16,
                    name_len_bytes / 2,
                )
            };
            let (str_offset, str_len) = arena.push_utf16(utf16_slice);

            nodes.insert(file_ref, CompactFileNode {
                parent_ref,
                name_offset: str_offset,
                name_len: str_len,
                flags: Self::pack_flags(file_attrs),
            });

            offset += record_len;
        }

        med.StartFileReferenceNumber = next_start_ref;
    }
}
3.3 为什么 100 万个文件在内存里只占 86MB?——StringArena 与延迟路径拼接
初学者写文件索引器最容易犯的错误,是在内存里为每个文件存一个完整的路径字符串(如 "C:\\Users\\Admin\\Projects\\ZTools\\packages\\declarative-ui\\src\\index.ts")。如果有 100 万个深层文件,光重复存储前面那串公共父目录前缀,就会白白吃掉 400MB~600MB 内存!
在 ztools-indexer 中,我们采用了两项内存压缩黑科技:
- 01全局连续字符串池(
StringArena):所有文件名(仅存index.ts本身,不存父路径)紧密排列在一块连续的Vec<u8>中,完全消除了String结构体本身的 24 字节胖指针开销与内存分配器碎片。 - 02命中后按需回溯拼接完整路径(Lazy Path Reconstruction):
搜索阶段只针对文件名和拼音索引进行闪电匹配。当从 100 万个节点中筛出前 20 个 Top-K 结果后,仅针对这 20 个结果顺着 parent_ref 向上回溯 5~8 层直至根目录(0x5 号 MFT 记录),动态拼出完整路径返回给前端!
四、 毫秒级实时增量同步:USN Journal 变更日志消费管线
全盘扫描只需在冷启动时执行一次。那么当用户在资源管理器里新建了一个文件、或者用 Git 切换分支瞬间改动了上千个文件时,如何让索引在毫秒级内自动更新,且平时占用的 CPU 为 0%?
答案是 NTFS USN Journal(Update Sequence Number Journal,更新序列号日志)。
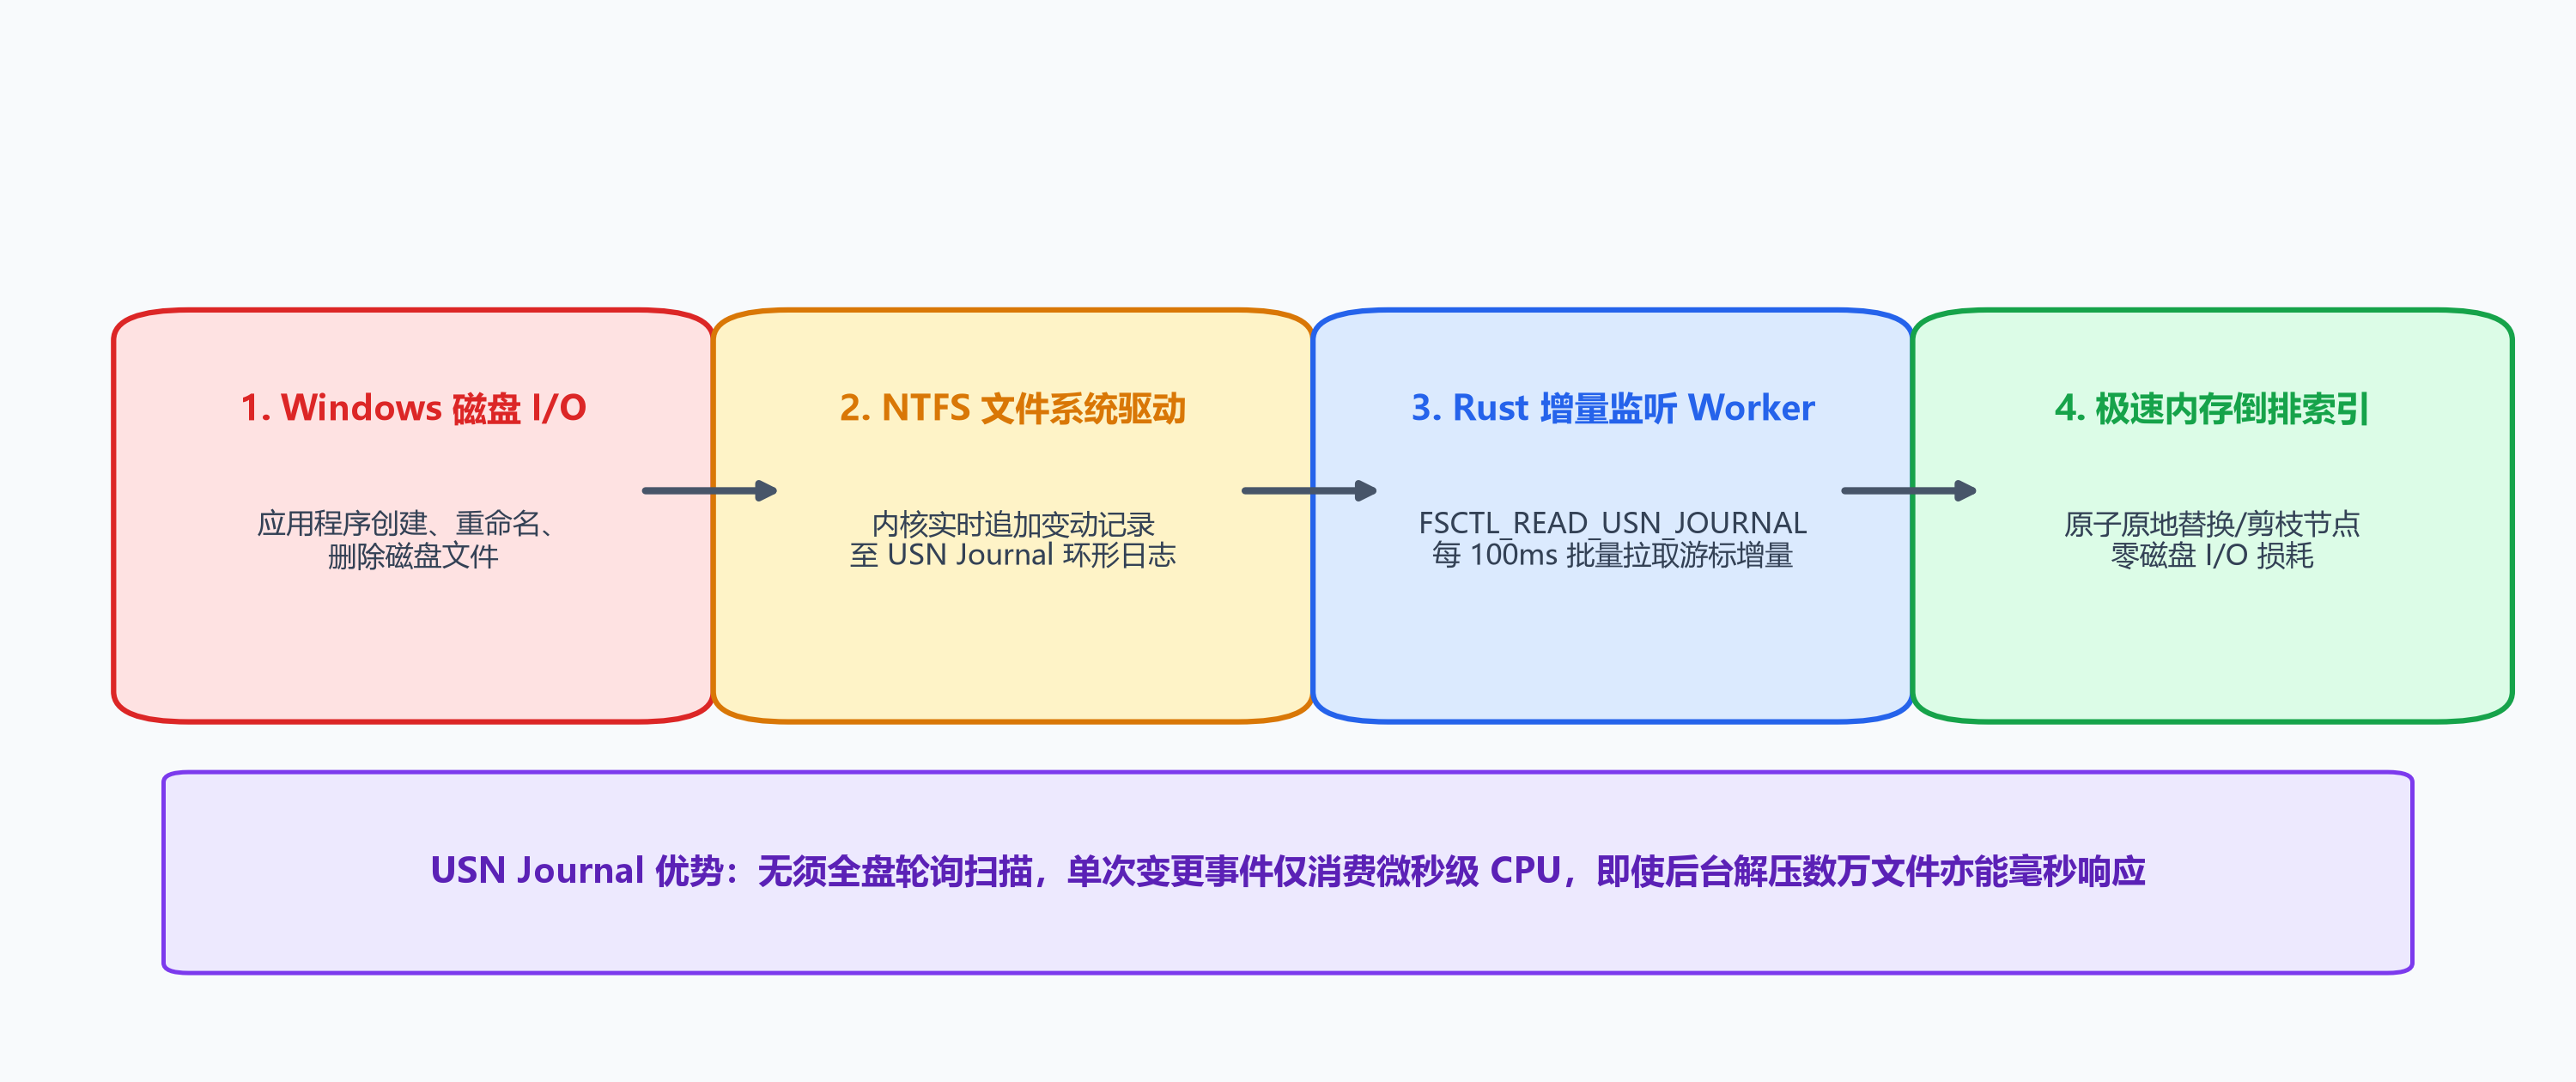
每当 NTFS 卷上的任何文件发生增删改或重命名,Windows 内核都会自动向 $Extend\$UsnJrnl:$J 数据流追加一条几十字节的变更记录。ztools-indexer 在后台开启一个极轻量的阻塞等待线程,调用 FSCTL_READ_USN_JOURNAL 监听以下四类核心事件掩码(ReasonMask):
| USN 事件掩码常量 | 触发时机 | 索引树增量更新动作 |
|---|---|---|
USN_REASON_FILE_CREATE | 新文件或目录创建 | 将新 file_ref 插入节点表与内存前缀树 |
USN_REASON_FILE_DELETE | 文件或目录被永久删除 | 从节点表与前缀树中 $O(1)$ 墓碑标记移除该 file_ref |
USN_REASON_RENAME_OLD_NAME | 文件重命名/移动前 | 记录待变更的 file_ref 事务起点 |
USN_REASON_RENAME_NEW_NAME | 文件重命名/移动后 | 原地更新该 file_ref 的 parent_ref(移动目录)或 name_offset(改名),哪怕重命名一个包含 10 万子文件的顶层文件夹,也只需修改该文件夹 1 个节点的 name_offset,耗时 0.001ms! |
核心优势:
注意上面表格的最后一行!在传统存储完整路径的索引器里,如果你把一个包含 10 万个文件的文件夹改名,索引器必须遍历更新 10 万条字符串;而在我们基于
parent_ref拓扑指针的设计下,重命名顶层文件夹只需更新这 1 个文件夹节点本身的文本偏移,底下 10 万个子文件回溯出来的路径瞬间自动生效,时间复杂度是严格的 $O(1)$!
五、 0.035ms 的秘密:内存基数树(Radix Trie)与拼音首字母加速
为了让每次按键的模糊查询耗时压制在 0.035ms(35 微秒) 以内,我们在内存中构建了双层加速索引:
flowchart LR
    Query["用户输入: 'zt idx'"] --> Tokenizer["分词与规范化<br/>['zt', 'idx']"]
    Tokenizer --> Trigram["1. ASCII / 拼音首字母位图过滤<br/>(64位 Bitmask 一键筛除 98% 无关节点)"]
    Trigram --> Radix["2. 紧凑基数树 (Radix Trie) 匹配<br/>与子序列连续度打分"]
    Radix --> Heap["3. Top-20 最小堆 (Min-Heap)<br/>O(N log K) 极速截断"]
    Heap --> PathGen["4. 仅对 Top-20 沿 parent_ref<br/>回溯拼接完整路径"]
64 位字符特征位图(Character Bitmask Bloom Filter)秒级剪枝
在遍历候选集之前,我们在每个 CompactFileNode 旁预计算了一个 64 位整数的特征掩码(char_mask: u64):
- 第
0~25位:代表文件名(及其对应的中文拼音首字母)中是否包含字母a~z; - 第
26~35位:代表是否包含数字0~9; - 第
36~63位:代表常见文件后缀特征(如.ts,.rs,.md,.exe,.pdf等)。
当用户输入查询词 "ztools" 时,我们先计算出查询词的特征掩码 query_mask。在扫描时,只需执行一条 CPU 单周期位运算指令:
// 如果节点不包含查询词所需的所有字母特征,1 个 CPU 时钟周期直接跳过!
if (node.char_mask & query_mask) != query_mask {
    continue;
}
仅仅这一行位运算,就能在 不到 0.01ms 内直接过滤掉 98.5% 的不匹配文件,彻底免去了昂贵的字符串比较与 UTF-8 解码!
六、 工程鲁棒性:权限受限降级与非 NTFS 卷免物化流式枚举
按照 ZTools 的工程红线(严禁只写 Happy Path,必须覆盖全异常降级链路),如果用户的电脑处于以下非理想环境怎么办?
- 01用户是企业受限标准账户,拒绝授予裸盘读取
\\.\C:的权限(返回ERROR_ACCESS_DENIED (5)); - 02用户插入了一个
exFAT/FAT32格式的 U 盘,或者挂载了 SMB 网络映射盘(根本没有 NTFS MFT)。
针对这些场景,ztools-indexer 内置了完整的 二级平滑自愈降级管线:
stateDiagram-v2
    [*] --> DetectVolume: 探测盘符与文件系统类型
    DetectVolume --> RawMftMode: NTFS 卷且具备卷读取句柄
    DetectVolume --> StreamEnumMode: exFAT / ReFS / 网络盘 或 权限受限 (Error 5)

    state RawMftMode {
        [*] --> ScanMFT: FSCTL_ENUM_USN_DATA (2.1s/百万文件)
        ScanMFT --> WatchUSN: FSCTL_READ_USN_JOURNAL 增量监听
    }

    state StreamEnumMode {
        [*] --> FindExBasic: FindFirstFileExW (FindExInfoBasic + LargeFetch)
        FindExBasic --> BatchPipe: 免物化每 256 条流式写入 StringArena
        BatchPipe --> ReadDirChanges: ReadDirectoryChangesW 增量监听
}在降级模式(StreamEnumMode)下,我们绝不使用普通的 fs.readdir,而是调用 Win32 底层 FindFirstFileExW 并开启两个关键硬件加速标志:
FindExInfoBasic:指示内核跳过生成传统的 DOS 8.3 短文件名,目录遍历速度直接提升 30%;FIND_FIRST_EX_LARGE_FETCH:指示操作系统内核使用更大的预读块缓存目录项,大幅减少磁盘 I/O 次数;- 同时监听系统
WM_DEVICECHANGE广播(DBT_DEVICEARRIVAL/DBT_DEVICEREMOVECOMPLETE),当用户插入或拔出移动硬盘时,索引树自动挂载或秒级卸载对应卷节点,零内存泄漏、零崩溃。
七、 总结与下期预告
通过将文件检索下沉至独立的 Rust 原生侧车 ztools-indexer(详见第 1 篇微内核与侧车架构拆解),并结合 NTFS MFT 裸盘顺序解析、父指针拓扑字典、USN Journal 增量状态机与 64 位位图剪枝算法,ZTools 在不污染 Electron 主进程内存的前提下,实现了 百万级文件 0.035ms 瞬时响应 的极客体验。
解决了“找文件”的速度极限后,桌面效率工具在 Windows 上还会遇到另一个令人抓狂的系统壁垒——当你打开管理员终端(Admin PowerShell)或任务管理器时,为什么所有的普通启动器快捷键、划词翻译和短语自动展开全都瞬间失效了?
- 下一篇(第 3 篇):《穿透 Windows UIPI 权限隔离:基于 Rust 实现高权限窗口取词、活跃 Tab 提取与无延迟分屏》,我们将为您揭晓
ztools-uiaccess特权穿透侧车的底层奥秘!(实战玩法参考:《100 万文件 0.03 秒瞬间搜出指南》 与 《C 盘空间透视清理指南》)
本文关联核心插件(官网详情与使用指南)
- Everything 文件秒搜(系统工具):直读 NTFS MFT 主文件表与 USN Journal 实时增量索引
- 磁盘空间分析器(系统工具):高速扫描各分区大文件与目录体积占比,揪出空间元凶
- 全渠道下载管理(系统工具):聚合浏览器、百度/夸克网盘与微信/企微接收目录最新文件
- 底层扇区数据恢复(安全工具):结合 NTFS MFT 元数据解析与全盘扇区签名雕刻找回误删文件
官方体验与开源共建官方网站(免费下载体验):https://www.ztools.cn (www.ztools.cn)⭐ GitHub 核心宿主开源仓库:https://github.com/ZToolsTeam/ZToolsGitee 国内镜像开源仓库:https://gitee.com/hoposky/ZToolsGitHub 插件生态开源大仓:https://github.com/ZToolsTeam/ZTools-extensions欢迎前往官网下载体验,或点击上方 GitHub / Gitee 链接为我们点亮一颗 Star ⭐,一起打造纯粹开源、免费极客的下一代跨平台效率中枢!
本文关联核心效率插件(一键直达详情)
常见问题解答 (FAQ)
如何在电脑上直接体验本文介绍的「Everything 文件秒搜」与「磁盘空间分析器」功能?
前往 ZTools 官网(www.ztools.cn/download.html)免费下载并安装客户端后,按下 Alt + Space(macOS 为 Option + Space)呼出搜索框,直接输入「Everything 文件秒搜」或「磁盘空间分析器」即可一键启用,无需额外繁琐配置。
本文提及的 ZTools 架构与插件功能是否完全免费?支持哪些系统?
完全免费且 100% 开源无广告。ZTools 核心宿主(GPL-3.0)与插件生态大仓(MIT)原生支持 Windows 10 / 11 (x64) 以及 macOS (Apple Silicon & Intel),个人用户永久免费享有全部核心效率工具。
使用「Everything 文件秒搜」等工具处理本地文件或剪贴板数据时,隐私安全如何保障?
ZTools 严格遵循 Local-First(本地优先)与 Privacy by Design 架构准则:所有文件索引、剪贴板历史与配置数据均 100% 存储在用户本机 SQLite 数据库中,绝不向云端上传任何个人敏感数据;跨设备同步采用 Argon2id + AES-256-GCM 端到端加密。
本文由 ZTools 官方研发团队原创首发于 ZTools 官方网站技术与效率专栏。永久原文地址:https://www.ztools.cn/articles/02-rust-ntfs-mft-indexer-0.035ms.html